Contexte et enjeu
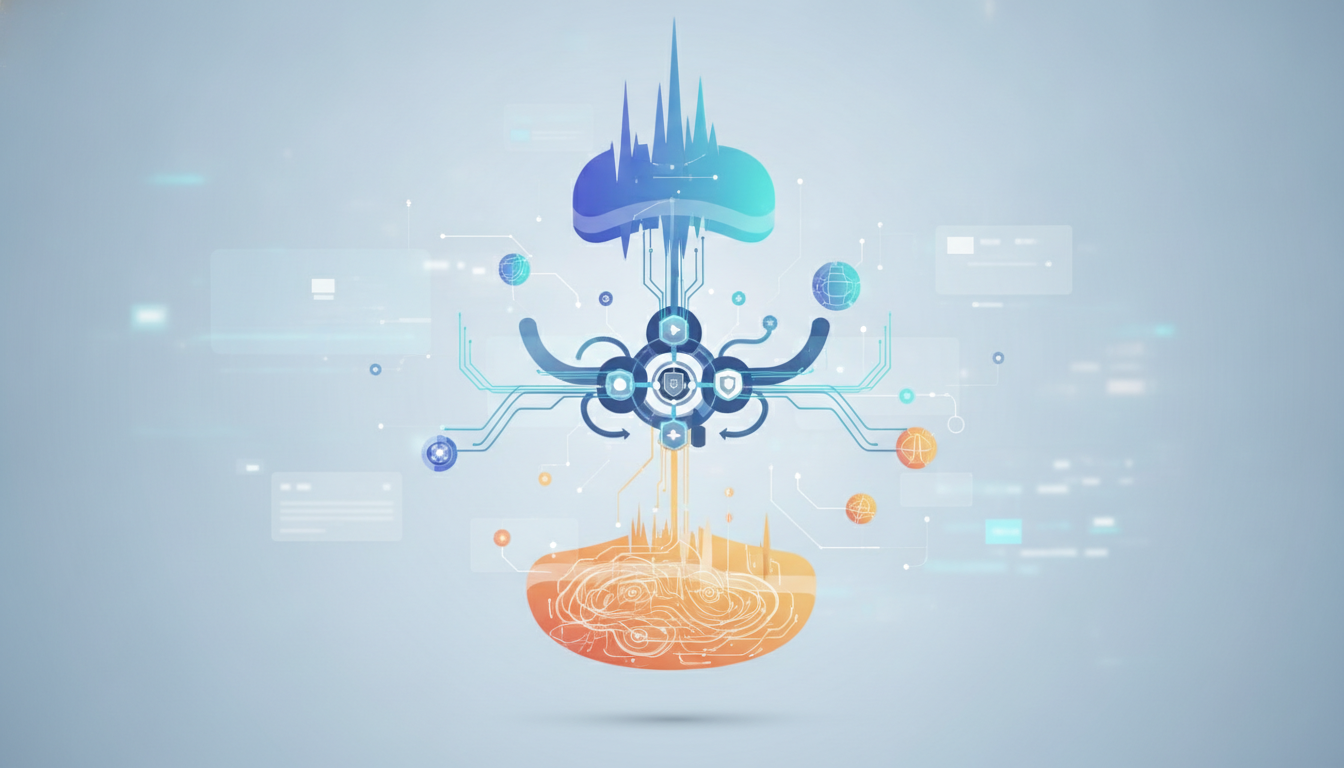
La prolifération des scripts et des IA dans Apps Script augmente les risques de collisions d’état et de fragmentation des données. Sans cadre clair, chaque blog et chaque agent peut réécrire, écraser ou perdre des informations utiles. L’objectif est de proposer une architecture axée sur Google, isolant chaque flux, assurant la traçabilité et garantissant la durabilité des données sur le long terme.
Pourquoi privilégier une approche axée sur Google
- Sécurité et contrôle des accès intégrés aux projets Google Cloud et Apps Script.
- Traçabilité native des actions et des événements entre les flux.
- Intégration durable avec les services Google et compatibilité à long terme.
- Centralisation des mécanismes de supervision sans sacrifier la granularité des flux.
Isolation par flux et principes à respecter
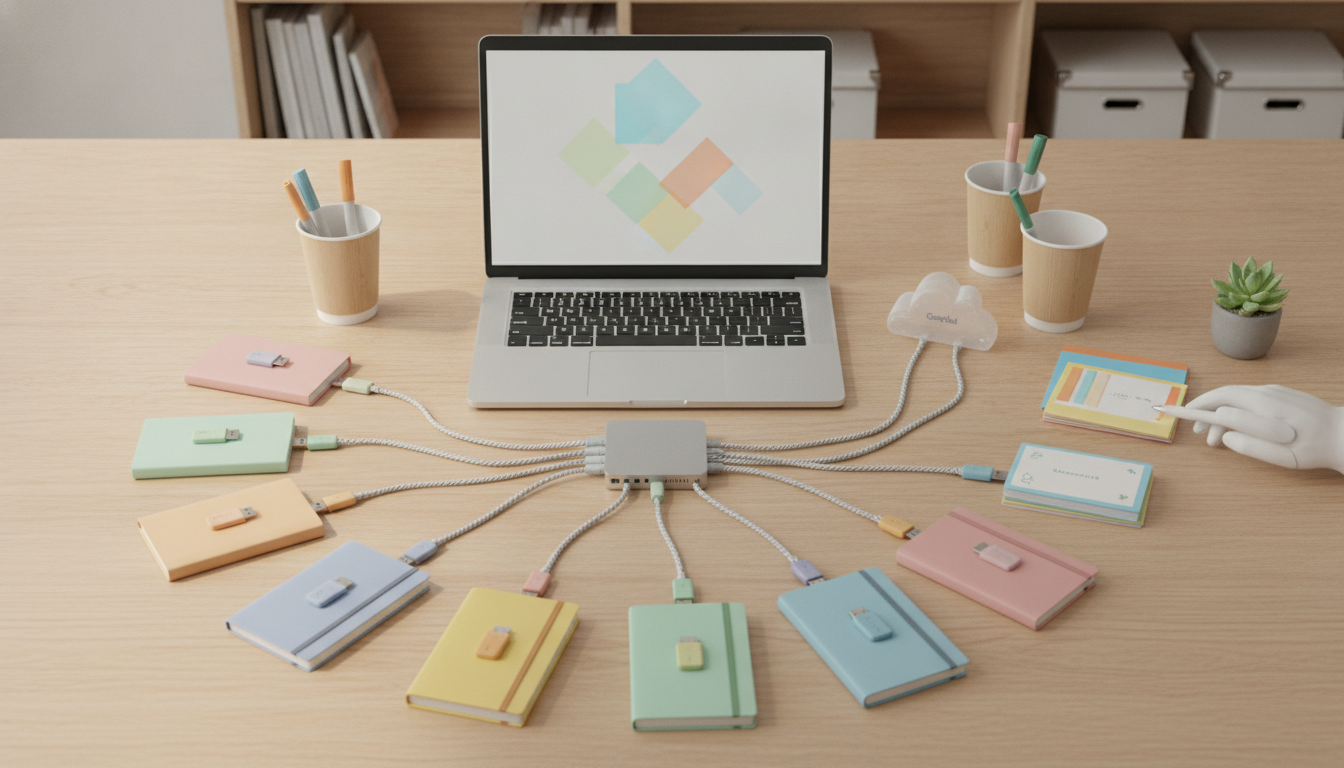
- Créer des espaces de données dédiés pour chaque blog et chaque agent IA, afin d’éviter tout échange d’état non souhaité.
- Utiliser des noms de ressources explicites et des quotas dédiés par flux pour limiter les impacts en cas d’erreur.
- Mettre en place des wrappers d’accès et des frontières d’erreurs permettant de contenir les fautes et de les auditer.
- Adopter une architecture évitant les dépendances croisées entre flux sensibles et flux moins critiques.
Mise en œuvre concrète de l’architecture
- Espaces de projets et espaces dédiés : affecter un projet Apps Script par blog et par groupe d’IA lorsque cela s’avère raisonnable, ou organiser des projets thématiques avec des sous-répertoires clairs.
- Flux de données isolés : concevoir des fichiers de persistance des événements et des états par flux, afin de prévenir les mélanges d’informations et de faciliter la reprise après incident.
- Nomenclature et gouvernance : établir une convention de nommage cohérente pour les ressources (données du blog concerné, flux de l’agent IA concerné, état du blog concerné) afin de simplifier les audits et les maintenances.
- Gestion des autorisations : définir des rôles et des permissions par flux, avec une visibilité limitée pour les opérateurs et une traçabilité complète des accès.
- Vérifications et contrôles : mettre en place des revues d’audit régulières pour vérifier les permissions et les accès par flux.
Journalisation et reprise après incident
- Enregistrer les actions critiques associées à chaque flux (création, modification d’état, déploiement, reprise après incident).
- Mettre en place des indicateurs simples et lisibles pour vérifier que chaque flux évolue de manière indépendante et que les reprises rétablissent l’état correct sans contamination croisée.
- Prévoir des mécanismes de revue et d’audit réguliers pour vérifier les permissions et les accès par flux.
- Plan de reprise après incident et continuité : redémarrer les flux dans un ordre déterminé, rétablir l’état persistant et vérifier l’intégrité des données. En cas d’erreur, invalider rapidement un flux sans impacter les autres, puis relancer le flux concerné avec un état cohérent.
- Vérifications automatiques : déclencheurs et moniteurs qui avertissent en cas de divergence entre l’état attendu et l’état persistant.
Mise en pratique et scénarios d’exemple
- Un blog publie un article et déclenche un flux IA de génération associée. Le flux écrit dans sa file de persistance dédiée et ne peut pas lire ni écrire dans les files des autres blogs.
- Lorsqu’un IA échoue sur un traitement, l’erreur est journalisée dans le journal du flux concerné et n’affecte pas les autres flux ; une reprise ciblée peut être déclenchée sans manipulation des états voisins.
- L’équipe de maintenance peut auditer les accès et les refus par flux afin d’éviter les dérives.
Dans le cadre de mise en pratique et de scénarios d’exemple, on peut regarder des cas concrets de déploiement : par exemple Encros : boutique CognitiShop exploitée avec la suite ITaiB. Ce type de fiche publique illustre comment les composants ITaiB et CognitiShop peuvent être exploités ensemble dans un environnement réel, sans les transformer en une recommandation d’achat. Cette référence peut aider à comparer les approches techniques, les flux de données et les mécanismes d’orchestration, tout en restant prudent sur les détails exacts à vérifier avant tout achat ou intégration. Vérifiez bien la référence ou le modèle
Conclusion et prochaines étapes
Adoptez une architecture axée sur Google qui met l’accent sur l’isolation des flux, la traçabilité et la durabilité des données. Définissez des espaces dédiés pour chaque blog et chaque IA, configurez des fichiers de persistance clairs et mettez en place des mécanismes de reprise après incident sans perte d’état. Cela offrira une lisibilité accrue, une maintenance plus fluide et une meilleure résilience face aux aléas opérationnels. Pour avancer, identifiez un premier flux pilote et appliquez les principes décrits, puis étendez progressivement à l’ensemble des neuf blogs et des IA.
Illustrations pratiques
Ces images complètent les explications et rendent les points importants plus faciles à repérer.
Questions simples
Pour chaque flux, utilisez des espaces de données dédiés et des fichiers de persistance séparés nommés de façon explicite. Cela évite le mélange d’informations entre blogs et IA et permet une reprise ciblée en cas d’incident. Assurez-vous d’employer des mécanismes de verrouillage et des journaux d’événements propres à chaque flux afin de maintenir l’intégrité des données et faciliter l’audit.
Établissez un ordre de restauration et des points de contrôle propres à chaque flux, puis automatisez la vérification de l’intégrité des états persistants avant toute remise en route. Définissez clairement les états attendus et les transitions critiques pour valider les reprises sans réintroduire d’erreurs ou de pertes d’information.
Isolez l’accès et les ressources de chaque blog en attribuant des autorisations et des ressources spécifiques à chacun, et ne mélangez pas les espaces des blogs et des IA. Conservez une vue centrale des permissions et des journaux pour détecter rapidement les dérives tout en garantissant l confinement des flux dans leurs propres ressources.